System Design: escalar a un millón de usuarios
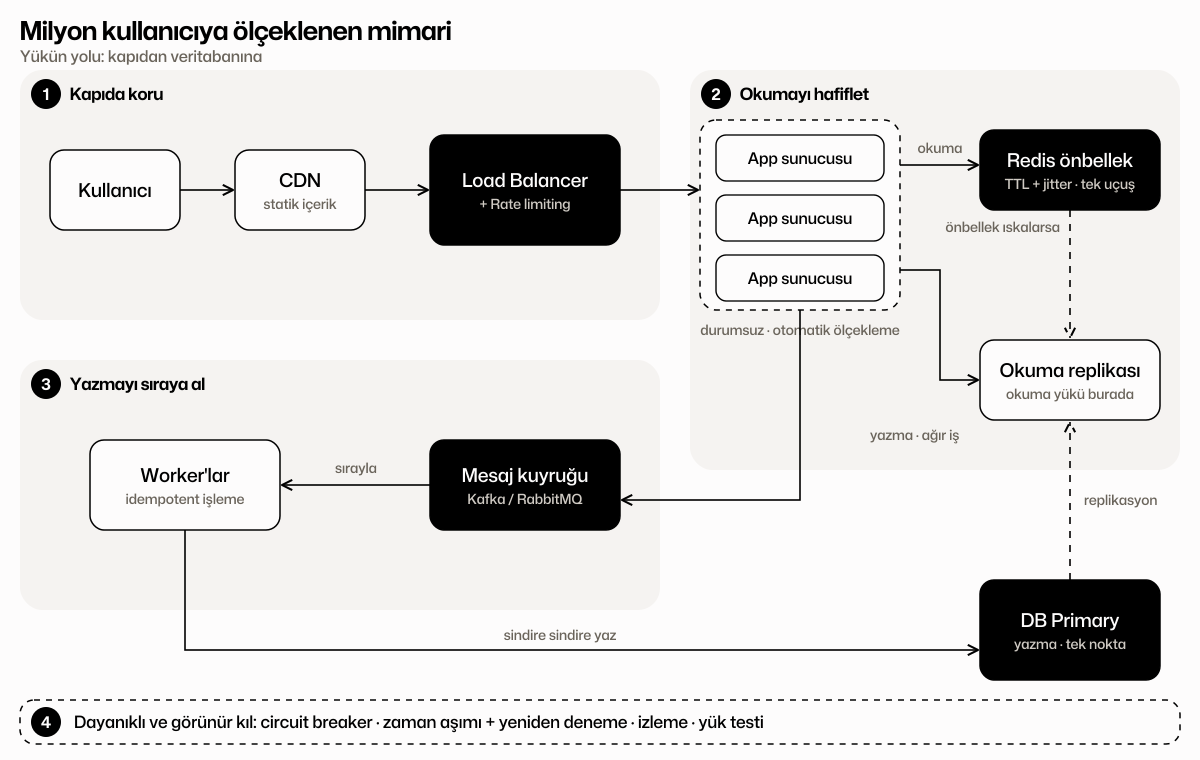
Este mapa sigue el vídeo "Tienen Kubernetes y presupuesto ilimitado, y aun así se cae". En lugar de memorizar un diagrama, sigue el camino de la carga y muestra qué problema resuelve cada capa.
El orden es deliberado: plantear el problema, proteger la puerta, aligerar las lecturas, encolar las escrituras y, por último, hacerlo resiliente y visible. Cada paso existe porque el anterior no era suficiente.
- EsencialDomínalo bien antes de postularte
- RecomendableAparece mucho en ofertas de empleo y te da ventaja
- Más adelanteCuando ya estés trabajando y lo necesites
Haz clic en un tema para ver qué necesitas saber y dónde aprenderlo.
- 01
¿Por qué se cae?
Añadir servidores no basta: el cuello de botella siempre es la parte compartida. Empieza por plantear el problema.
- 02
Protege la puerta
Recortar la carga antes de que llegue a la base de datos es más barato que perseguirla.
- 03
Aligera las lecturas
La mayor parte del tráfico son lecturas. Deja de pedir una y otra vez los mismos datos a la base de datos.
- 04
Encola las escrituras
No empujes el trabajo pesado directamente a la base de datos; encólalo y procésalo de forma constante.
- 05
Hazlo resiliente y visible
Algo se va a romper. Lo importante es que no se caiga todo a la vez y que puedas ver qué falló.
Tema por tema
Todos los temas del mapa con su descripción, qué saber y recursos, en una sola lista.
01¿Por qué se cae?
Dos formas de escalar· Esencial
El escalado vertical hace más grande la máquina; el horizontal añade más máquinas. Los servidores de aplicación escalan horizontalmente; la base de datos suele ser lo primero que se atasca.
Lo que deberías saber
- Vertical: fácil, pero tiene un techo
- Horizontal: casi ilimitado, pero requiere estado compartido
- Mantén los servidores de aplicación stateless
Recursos
Servidores de aplicación stateless· Esencial
Saca las sesiones y los archivos de la memoria del servidor para que cualquier servidor pueda sustituir a otro.
Lo que deberías saber
- Guarda las sesiones en Redis o en tokens firmados
- Escribe los archivos en almacenamiento de objetos, no en el disco local
Punto único de fallo· Recomendable
Una sola base de datos con la que hablan todos los servidores, un único componente en el medio: si cae, cae todo.
Lo que deberías saber
- Pregúntate '¿qué pasa si esto se muere?' por cada pieza
Por qué se atasca la base de datos· Esencial
Las conexiones, el disco y los bloqueos son finitos. Cuando veinte servidores envían miles de escrituras a la vez, se llena el límite de conexiones y las solicitudes hacen cola unas detrás de otras.
Lo que deberías saber
- Pool de conexiones y límite de conexiones
- Contención de bloqueos y consultas lentas
- Cuando se atasca, la latencia se multiplica de golpe
Recursos
Connection pooling· Recomendable
Comparte un conjunto limitado de conexiones en lugar de abrir una por solicitud; protege la base de datos de las tormentas de conexiones.
Lo que deberías saber
- Un pooler como PgBouncer
- Servidores × tamaño del pool = conexiones que llegan a la base de datos
02Protege la puerta
Load balancer· Esencial
Reparte el tráfico entrante entre los servidores sanos y retira los caídos. Sin un punto de entrada único, el escalado horizontal no significa nada.
Lo que deberías saber
- Round-robin, least-connections y similares
- Health checks
- L4 vs L7
Recursos
Health checks· Recomendable
La aplicación informa de su propio estado para que el balanceador deje de enviar tráfico a un servidor enfermo.
Lo que deberías saber
- Un endpoint /health ligero; separa el liveness de las dependencias
Rate limiting· Esencial
Limita cuántas solicitudes por segundo puede hacer un cliente, o todos juntos; la carga excedente se rechaza antes de entrar para que el sistema siga en pie.
Lo que deberías saber
- Token bucket y ventana fija
- 429 Too Many Requests + Retry-After
- Límites por identidad y por IP
Recursos
Sala de espera virtual· Más adelante
Para lanzamientos de entradas: pon a los usuarios en cola y déjalos pasar al ritmo que el sistema pueda soportar.
Lo que deberías saber
- Encolar en lugar de rechazar
CDN y contenido estático· Recomendable
Las imágenes, los scripts y las páginas que no cambian se sirven desde ubicaciones edge cercanas al usuario; el origen nunca las ve.
Lo que deberías saber
- Cabeceras Cache-Control
- Cachear brevemente las páginas dinámicas
Recursos
03Aligera las lecturas
Caché (Redis)· Esencial
Una capa rápida en memoria para los datos calientes. Quita la mayoría de las lecturas de la base de datos, pero mal configurada crea sus propios problemas.
Lo que deberías saber
- El patrón cache-aside
- TTL e invalidación
- La caché también puede fallar: ¿sobrevivirá la base de datos a eso?
Recursos
Patrón cache-aside· Esencial
Consulta primero la caché; si falla, lee la base de datos, rellena la caché y devuelve el dato. El patrón más común y sencillo.
Lo que deberías saber
- Dos pasos al leer; invalida al escribir
Invalidación de caché· Recomendable
Cuándo y cómo descartar la copia obsoleta cuando cambian los datos: uno de los problemas difíciles de la informática.
Lo que deberías saber
- Confía en el TTL; para datos críticos, elimina al escribir
Cache stampede· Esencial
En el momento en que expira una clave caliente, cientos de miles de solicitudes fallan en la caché y llegan a la vez a la base de datos. La advertencia principal del vídeo.
Lo que deberías saber
- Añade jitter aleatorio a los TTL
- Single-flight: solo una solicitud refresca
- Servir contenido obsoleto mientras se revalida
Recursos
Jitter en el TTL· Recomendable
Un pequeño desfase aleatorio en la expiración para que las claves escritas juntas no expiren juntas.
Lo que deberías saber
- 3600 s pasa a ser 3600 ± 10%
Single-flight / locking· Recomendable
Solo una solicitud por clave va a la base de datos; las demás esperan su resultado o toman el valor obsoleto.
Lo que deberías saber
- Lock distribuido o single-flight dentro del proceso
Réplicas de lectura· Recomendable
Las escrituras van a una primaria y las lecturas a una o varias copias. La carga de lectura se reparte entre las réplicas.
Lo que deberías saber
- Retraso de replicación
- Lee de la primaria cuando necesites leer tu propia escritura
Recursos
04Encola las escrituras
Colas de mensajes· Esencial
El trabajo pesado, como la venta de entradas y los pedidos, entra primero en una cola y los workers la vacían a su propio ritmo. La cola absorbe el pico y la base de datos se mantiene tranquila.
Lo que deberías saber
- Productor, cola, consumidor
- Responde 'recibido' de inmediato y notifica el resultado después
- Kafka vs RabbitMQ
Recursos
¿Kafka o RabbitMQ?· Recomendable
RabbitMQ sirve para distribuir tareas; Kafka, para flujos de eventos de gran volumen y replay. Cualquiera basta para tu primera cola.
Lo que deberías saber
- Primero mira el trabajo, después elige la herramienta
Backpressure· Más adelante
Frena o rechaza a los productores cuando los consumidores no pueden seguir el ritmo, para que la cola no crezca sin límite.
Lo que deberías saber
- Alerta sobre la longitud de la cola
Idempotencia· Esencial
Un mismo mensaje puede procesarse dos veces desde una cola; para no cobrar dos veces, la operación debe poder repetirse sin riesgo.
Lo que deberías saber
- Una clave única por solicitud
- Registra las claves ya procesadas
Recursos
Separación de lectura/escritura (CQRS)· Más adelante
Separar el modelo de escritura del modelo de lectura; cada uno escala y almacena según sus propias necesidades.
Lo que deberías saber
- Actualizaciones orientadas a eventos
- Su coste es la complejidad: solo cuando sea realmente necesario
Recursos
05Hazlo resiliente y visible
Circuit breaker· Recomendable
Deja de enviar solicitudes durante un tiempo a una dependencia que no responde, para que el resto del sistema no caiga con ella.
Lo que deberías saber
- Timeouts más reintentos con exponential backoff
- Un comportamiento de fallback
Recursos
Autoscaling· Recomendable
Herramientas como Kubernetes añaden servidores de aplicación según la carga; la base de datos no puede hacerlo automáticamente, y por eso importan las capas anteriores.
Lo que deberías saber
- Escalar según la CPU y la tasa de solicitudes
- Retraso de cold start al escalar
Recursos
Monitorización y pruebas de carga· Esencial
No puedes escalar lo que no ves. Antes del gran día, carga el sistema a propósito y descubre dónde se rompe.
Lo que deberías saber
- Latencia (p95/p99), tasa de errores, saturación
- Haz pruebas de carga en un entorno similar a producción
Recursos