System Design: Skalierung auf eine Million Nutzer
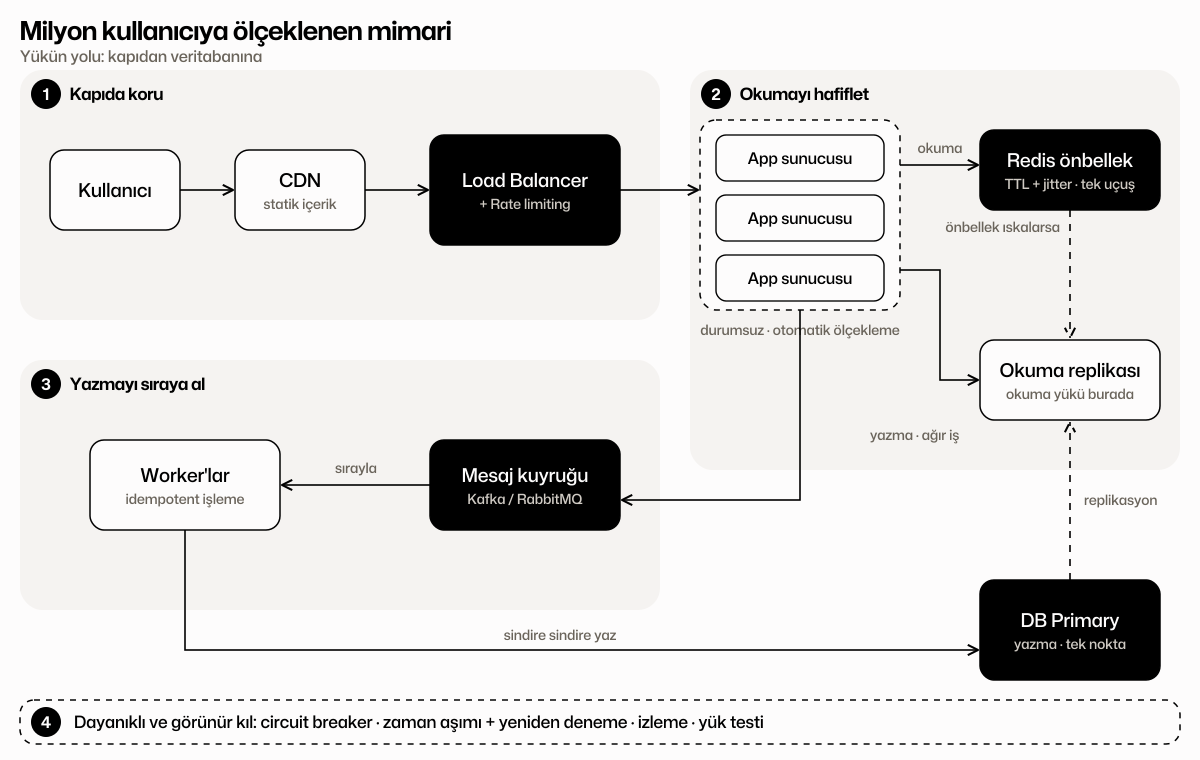
Diese Karte folgt dem Video „Die haben Kubernetes und unbegrenztes Budget, und trotzdem fällt es um“. Statt ein einzelnes Diagramm auswendig zu lernen, folgt sie dem Weg der Last und zeigt, welches Problem jede Schicht löst.
Die Reihenfolge ist bewusst gewählt: Problem eingrenzen, die Tür schützen, Lesezugriffe entlasten, Schreibzugriffe einreihen, dann für Ausfallsicherheit und Sichtbarkeit sorgen. Jeder Schritt existiert, weil der vorherige nicht ausgereicht hat.
- KernDas solltest du gut können, bevor du dich bewirbst
- WünschenswertTaucht oft in Stellenanzeigen auf und verschafft dir einen Vorteil
- SpäterWenn du im Job bist und es brauchst
Klicke auf ein Thema, um zu sehen, was du wissen musst und wo du es lernen kannst.
- 01
Warum fällt es um?
Mehr Server reichen nicht: Der Engpass ist immer der gemeinsam genutzte Teil. Grenze zuerst das Problem ein.
- 02
Die Tür schützen
Last zu reduzieren, bevor sie die Datenbank erreicht, ist günstiger, als ihr hinterherzulaufen.
- 03
Lesezugriffe entlasten
Der meiste Traffic besteht aus Lesezugriffen. Hör auf, immer wieder dieselben Daten aus der Datenbank zu holen.
- 04
Schreibzugriffe einreihen
Schiebe aufwendige Arbeit nicht direkt in die Datenbank; reihe sie ein und arbeite sie gleichmäßig ab.
- 05
Ausfallsicher und sichtbar machen
Irgendetwas wird kaputtgehen. Entscheidend ist, dass nicht alles zusammen ausfällt und dass du siehst, was kaputt ist.
Thema für Thema
Jedes Thema auf der Karte mit Beschreibung, Wissenswertem und Ressourcen — in einer Liste.
01Warum fällt es um?
Zwei Wege der Skalierung· Kern
Vertikale Skalierung macht die Maschine größer, horizontale Skalierung fügt weitere hinzu. App-Server skalierst du horizontal; die Datenbank ist meist die Stelle, an der es zuerst klemmt.
Das solltest du wissen
- Vertikal: einfach, aber mit Obergrenze
- Horizontal: nahezu unbegrenzt, braucht aber geteilten Zustand
- App-Server zustandslos halten
Ressourcen
Zustandslose App-Server· Kern
Verlagere Sessions und Dateien aus dem Server-Speicher, damit jeder Server jeden anderen ersetzen kann.
Das solltest du wissen
- Sessions in Redis oder in signierten Tokens halten
- Dateien in Object Storage schreiben, nicht auf die lokale Festplatte
Single Point of Failure· Wünschenswert
Eine einzige Datenbank, mit der alle Server sprechen, eine einzelne Komponente in der Mitte: Fällt sie aus, fällt alles aus.
Das solltest du wissen
- Frag bei jeder einzelnen Komponente: „Was passiert, wenn sie ausfällt?“
Warum die Datenbank klemmt· Kern
Verbindungen, Festplatte und Locks sind begrenzt. Wenn zwanzig Server gleichzeitig Tausende Schreibzugriffe schicken, ist das Verbindungslimit schnell erreicht und die Anfragen stauen sich hintereinander.
Das solltest du wissen
- Connection Pool und Verbindungslimit
- Lock Contention und langsame Abfragen
- Klemmt es einmal, vervielfacht sich die Latenz schlagartig
Ressourcen
Connection Pooling· Wünschenswert
Teile dir eine begrenzte Anzahl an Verbindungen, statt pro Anfrage eine zu öffnen; das schützt die Datenbank vor Verbindungsstürmen.
Das solltest du wissen
- Ein Pooler wie PgBouncer
- Server × Pool-Größe = Verbindungen, die auf die Datenbank treffen
02Die Tür schützen
Load Balancer· Kern
Verteilt eingehenden Traffic auf gesunde Server und nimmt ausgefallene aus dem Verkehr. Ohne einen zentralen Einstiegspunkt bedeutet horizontale Skalierung nichts.
Das solltest du wissen
- Round-Robin, Least-Connections und Co.
- Health Checks
- L4 vs. L7
Ressourcen
Health Checks· Wünschenswert
Die App meldet ihren eigenen Zustand, damit der Balancer keinen Traffic mehr an einen kranken Server schickt.
Das solltest du wissen
- Ein leichtgewichtiger /health-Endpoint; Liveness von Abhängigkeiten trennen
Rate Limiting· Kern
Begrenzt, wie viele Anfragen ein Client oder alle zusammen pro Sekunde stellen dürfen; überschüssige Last wird abgewiesen, bevor sie hineinkommt, damit das System stabil bleibt.
Das solltest du wissen
- Token Bucket und Fixed Window
- 429 Too Many Requests + Retry-After
- Limits pro Identität und pro IP
Ressourcen
Virtueller Warteraum· Später
Für Ticket-Drops: Nutzer in eine Warteschlange stellen und in einem Tempo hineinlassen, das das System verkraftet.
Das solltest du wissen
- Einreihen statt abweisen
CDN und statische Inhalte· Wünschenswert
Bilder, Skripte und unveränderliche Seiten werden von Edge-Standorten in Nutzernähe ausgeliefert; der Origin bekommt sie nie zu sehen.
Das solltest du wissen
- Cache-Control-Header
- Dynamische Seiten kurz cachen
Ressourcen
03Lesezugriffe entlasten
Caching (Redis)· Kern
Eine schnelle In-Memory-Schicht für häufig genutzte Daten. Sie nimmt der Datenbank die meisten Lesezugriffe ab, kann bei falscher Konfiguration aber eigene Probleme verursachen.
Das solltest du wissen
- Das Cache-Aside-Pattern
- TTL und Invalidierung
- Auch der Cache kann ausfallen: Übersteht die Datenbank das?
Ressourcen
Cache-Aside-Pattern· Kern
Prüfe zuerst den Cache; bei einem Miss liest du aus der Datenbank, befüllst den Cache und gibst das Ergebnis zurück. Das häufigste und einfachste Pattern.
Das solltest du wissen
- Zwei Schritte beim Lesen; beim Schreiben invalidieren
Cache-Invalidierung· Wünschenswert
Wann und wie du die veraltete Kopie verwirfst, wenn sich Daten ändern: eines der schwierigen Probleme der Informatik.
Das solltest du wissen
- Auf TTL setzen; bei kritischen Daten beim Schreiben löschen
Cache Stampede· Kern
Sobald ein stark genutzter Key abläuft, treffen Hunderttausende Anfragen auf einen Cache Miss und gehen gleichzeitig an die Datenbank. Die Hauptwarnung des Videos.
Das solltest du wissen
- Zufälligen Jitter auf TTLs addieren
- Single-Flight: Nur eine Anfrage aktualisiert
- Veraltete Daten ausliefern, während neu validiert wird
Ressourcen
TTL-Jitter· Wünschenswert
Ein kleiner zufälliger Versatz beim Ablauf, damit Keys, die gemeinsam geschrieben wurden, nicht gemeinsam ablaufen.
Das solltest du wissen
- Aus 3600 s werden 3600 ± 10 %
Single-Flight / Locking· Wünschenswert
Pro Key geht nur eine Anfrage an die Datenbank; die anderen warten darauf oder nehmen den veralteten Wert.
Das solltest du wissen
- Distributed Lock oder In-Process-Single-Flight
Read Replicas· Wünschenswert
Schreibzugriffe gehen an eine primäre Datenbank, Lesezugriffe an eine oder mehrere Kopien. Die Leselast verteilt sich auf die Replicas.
Das solltest du wissen
- Replikationsverzögerung
- Von der primären Datenbank lesen, wenn du deine eigene Änderung lesen musst
Ressourcen
04Schreibzugriffe einreihen
Message Queues· Kern
Aufwendige Vorgänge wie Ticketverkäufe und Bestellungen landen zuerst in einer Queue, und Worker arbeiten sie in ihrem eigenen Tempo ab. Die Queue fängt die Lastspitze ab, und die Datenbank bleibt ruhig.
Das solltest du wissen
- Producer, Queue, Consumer
- Sofort mit „erhalten“ antworten, das Ergebnis später mitteilen
- Kafka vs. RabbitMQ
Ressourcen
Kafka oder RabbitMQ?· Wünschenswert
RabbitMQ eignet sich für die Verteilung von Aufgaben, Kafka für Event-Streams mit hohem Volumen und Replay. Für deine erste Queue reicht beides.
Das solltest du wissen
- Erst den Job anschauen, dann das Tool wählen
Backpressure· Später
Bremse Producer aus oder weise sie ab, wenn die Consumer nicht mehr hinterherkommen, damit die Queue nicht endlos wächst.
Das solltest du wissen
- Bei Queue-Länge alarmieren
Idempotenz· Kern
Dieselbe Nachricht kann aus einer Queue zweimal verarbeitet werden; damit nicht doppelt abgebucht wird, muss die Operation sicher wiederholbar sein.
Das solltest du wissen
- Ein eindeutiger Key pro Anfrage
- Verarbeitete Keys speichern
Ressourcen
Trennung von Lesen und Schreiben (CQRS)· Später
Schreibmodell und Lesemodell werden getrennt; jedes skaliert und speichert nach seinen eigenen Anforderungen.
Das solltest du wissen
- Event-getriebene Updates
- Der Preis ist Komplexität: nur wenn wirklich nötig
Ressourcen
05Ausfallsicher und sichtbar machen
Circuit Breaker· Wünschenswert
Hört für eine Weile auf, Anfragen an eine Abhängigkeit zu senden, die nicht antwortet, damit der Rest des Systems nicht mit ausfällt.
Das solltest du wissen
- Timeouts plus Retries mit Exponential Backoff
- Ein Fallback-Verhalten
Ressourcen
Autoscaling· Wünschenswert
Tools wie Kubernetes fügen je nach Last App-Server hinzu; die Datenbank kann das nicht automatisch, deshalb sind die früheren Schichten so wichtig.
Das solltest du wissen
- Skalierung nach CPU und Request-Rate
- Cold-Start-Verzögerung beim Skalieren
Ressourcen
Monitoring und Lasttests· Kern
Was du nicht sehen kannst, kannst du nicht skalieren. Belaste das System vor dem großen Tag gezielt und finde heraus, wo es bricht.
Das solltest du wissen
- Latenz (p95/p99), Fehlerrate, Auslastung
- Lasttest in einem produktionsnahen Setup
Ressourcen